Çalışan bir GPU ve yüzde 5’lik iş hacmi iddiası
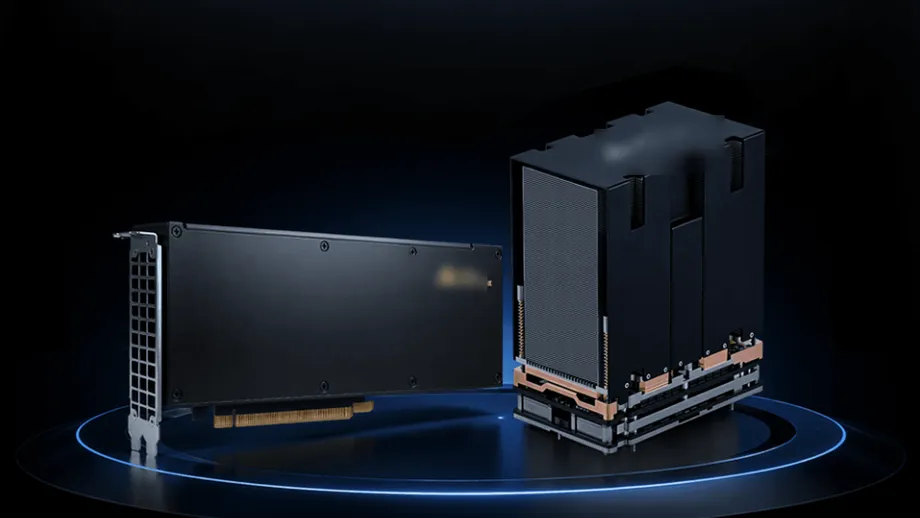
Iluvatar CoreX, Şanghay’da Tiangai 300 grafik işlemcisini kamuoyuna tanıtarak Nvidia’nın H200 modeline Çin’den bir alternatif sundu. Şirket, üçüncü tarafça gerçekleştirilen bir çıkarım testinde yüzde 5’lik üstünlük sağladığını öne sürdü. Şirket, 28 Ekim 2026’daki medya etkinliğinde sekiz GPU’lu bir eğitim sistemi de sergiledi ve 144 GPU ile 18 CPU içeren bir sistemi tanıttı.
İçindekiler
- Çalışan bir GPU ve yüzde 5’lik iş hacmi iddiası
- H200 karşılaştırması neyi ölçüyor?
- Uzun belgeler ve daha hızlı ilk yanıtlar
- Eğitim sonuçlarında farklı bir Nvidia modeli referans alındı
- Temmuzdaki lansmandan ekim ayındaki gösterime
- 144 GPU etrafında tasarlanan bir sistem
- Yapay zekâ işlerini farklı çipler arasında paylaştırma
- Yazılım iddiaları dağıtım süresini kısaltmayı hedefliyor
- TY1200, iddiayı robotlara da taşıyor
- Öne Çıkan Noktalar
Öne çıkan karşılaştırma, Iluvatar CoreX’e göre Shanghai Electric Group’un temmuz ayında tamamladığı testten geliyor. Büyük dil modeli işlemenin iki aşamaya ayrıldığı bir kurulumda Tiangai 300, sonuçlar kart başına değere dönüştürüldüğünde H200’ün uçtan uca iş hacminin 1,05 katına ulaştı.
İş hacmi, bir sistemin belirli bir sürede ne kadar yararlı işi tamamladığını ifade eder. Bir sohbet robotunda bu, her saniye kaç metin parçası ürettiği anlamına gelebilir. Referans performansın 1,05 katı sonuç, test koşullarında yüzde 5 daha fazla çıktı demektir.
Şirket, ölçümlü testlerde H200 performansına ulaşan ilk Çin menşeli genel amaçlı GPU’nun Tiangai 300 olduğunu belirtti. Ekim ayındaki gösterimde karşılaştırma dil modelleri, görüntü üretimi ve video üretimini de kapsarken, ayrı bir eğitim gösteriminde referans olarak Nvidia’nın H100 modeli kullanıldı.
Etkinlikte bir çipin teknik özelliklerinden fazlası tanıtıldı. Iluvatar CoreX; kartları, sunucuları, yoğun GPU’lu bir sistem tasarımını, yazılım araçlarını ve farklı işlemci türleri arasında yapay zekâ işlerini paylaştırma yöntemini sergiledi. Şirketin ticari iddiası, bu bileşenlerin daha düşük maliyetle ve daha az bekleme süresiyle yararlı yapay zekâ çıktısı sağlayabileceği yönünde.
H200 karşılaştırması neyi ölçüyor?
Shanghai Electric Group’un temmuz ayındaki testinde, genellikle PD ayrımı olarak kısaltılan ön doldurma ve çözümleme ayrımı kullanıldı. Ön doldurma aşamasında dil modeli, kullanıcının isteğini ve isteği destekleyen materyali okur. Çözümleme aşamasında ise yanıtı her seferinde bir belirteç üreterek oluşturur. Belirteçler, yapay zekâ sistemlerinin metni bölümlere ayırdığı küçük parçalardır.
Bu aşamaları ayırmak, sistemin okuma ve yazma işleri için kaynakları farklı biçimde tahsis etmesini sağlar. Dolayısıyla Tiangai 300’ün sonucu, toplam performansın kart başına eşdeğer bir değer olarak ifade edildiği belirli bir kurulumla ilgilidir.
Iluvatar CoreX, öne çıkan üçüncü taraf testinin ayrıntılı yöntemini, model listesini veya iş yükü koşullarını yayımlamadı. Sonucun bağımsız biçimde tekrarlanabilmesi için bu ayrıntıların yanı sıra dönüştürme hesabı ve yazılım ayarları da gerekli. Maliyet karşılaştırmasının ayrıntıları da yayımlanmadı; ayrıca tek tek kartların ve sistemin tamamının bellek değerlerinin açıklığa kavuşturulması gerekiyor.
Performans laboratuvarının adı belirtilen gösterimleri, şirketin iddialarına dair daha ayrıntılı bir tablo sunuyor. Görev türüne göre, çok modlu üretimde küçük bir artıştan öneri işleme hacminde daha büyük bir yükselişe kadar farklı kazanımlar aktarılıyor. Alıcılar için önemli olan, kendi hizmetlerinde gerçekten yürüttükleri görevle yapılacak karşılaştırma.
Uzun belgeler ve daha hızlı ilk yanıtlar
Şirketin laboratuvarına göre Tiangai 300, 64K bağlam uzunluğunda H200 performansının 1,05 katına ulaşan dikkat işleme performansı gösterdi. Dikkat mekanizması, modelin girdisinin hangi bölümlerinin birbiriyle ilişkili olduğunu belirlemesine yardımcı olur. 64K bağlam uzunluğu, modelin yaklaşık 64.000 belirteç işlediği anlamına gelir.
Iluvatar CoreX, aynı bağlam ölçeğinde GLM-5.3 modelinde eşdeğer kullanıcı deneyimini korurken H200 performansının 1,15 katı iş hacmine ulaşıldığını öne sürdü. Test edilen uzman karışımı iş yükünde bu, yüzde 15’lik bir artış anlamına geliyor. Uzman karışımı model, her belirteç için tüm ağları kullanmak yerine işi seçilmiş uzman ağlara yönlendirir.
Bağlam uzunluklarının 8K ile 128K arasında değiştiği yapay zekâ ajanı iş yüklerinde şirket, ilk çıktı belirtecinin üretilmesini bekleme süresinin yaklaşık yüzde 10 ila 30 azaldığını bildirdi. Bu ölçüm, asistanın uzun bir belgeyi okumasını veya karmaşık bir isteği işlemesini bekledikten sonra yanıt vermeye başlamasını bekleyen kullanıcılar için önem taşıyor.
Görüntü ve video üretimi de gösterimin bir parçasıydı. Şirket, H200’e kıyasla çok modlu üretim iş hacminde yaklaşık yüzde 2 ila 5 artış bildirdi. Çevrimiçi arama, reklam ve öneri iş yüklerinde ise öneri çıkarım iş hacminin yüzde 21 daha yüksek, hafif hesaplamalardaki gecikmenin yüzde 26 daha düşük olduğunu öne sürdü.
Eğitim sonuçlarında farklı bir Nvidia modeli referans alındı
Eğitim gösteriminde yaklaşık 32 milyar parametreli Qwen3-32B modeli, sekiz GPU’lu bir sunucuda çalıştırıldı. Parametreler, modelin örüntüleri öğrenmek için eğitim sırasında ayarladığı sayısal değerlerdir. Iluvatar CoreX, kart başına etkin iş hacminin Nvidia H100’ün 1,33 katına ulaştığını belirtti.
Dolayısıyla H100’ün karşılaştırma çipi olarak kullanıldığı bu eğitim gösteriminde bildirilen üstünlük yüzde 33’tü. Etkinliğin diğer bölümlerindeki çıkarım sonuçlarında ise H200 kullanıldı. Rakamları doğru yorumlamak için bu referans ürünleri birbirinden ayrı tutmak gerekiyor.
Eğitim sistemi FP8 hassasiyetinde çalıştı. FP8, sayıları sekiz bit kullanarak saklar; böylece daha fazla bit kullanan biçimlere kıyasla taşınması ve işlenmesi gereken veri miktarı azalır. Yapay zekâ eğitim yazılımlarının, öğrenme kalitesini korumak için bu düşük hassasiyeti dikkatle yönetmesi gerekir.
Iluvatar CoreX ayrıca tam yükte uzun süreli çalışma sırasında adım süresi değişkenliğinin yüzde 0,43 olduğunu, Hopper tabanlı bir referans sisteminde ise bu oranın yüzde 0,76 olarak ölçüldüğünü bildirdi. Adım süresi, tekrarlanan bir iş birimini tamamlamak için gereken süredir. Daha tutarlı zamanlama, operatörlerin yoğun çalışan bir sistemin ne kadar işi tamamlayacağını planlamasına yardımcı olabilir.
Temmuzdaki lansmandan ekim ayındaki gösterime
Tiangai 300, Temmuz 2026’da Dünya Yapay Zekâ Konferansı’nda resmen tanıtıldı. Şirketin Tianshu mimarisini kullanan işlemci, yeni nesil Tensör Çekirdekleri içeriyor ve 144 GB grafik belleğiyle sunuluyor.
İşlemci skaler, vektör ve tensör işlemlerini destekliyor. Basitçe ifade etmek gerekirse bunlar sırasıyla tekil sayılar, sayı grupları ve daha büyük matematiksel diziler üzerinde işlem yapıyor. Desteklenen sayısal biçimler arasında FP4, FP8, FP16 ve BF16 bulunuyor. Bu biçimler yazılım geliştiricilere hız, bellek kullanımı ve sayısal hassasiyet açısından farklı seçenekler sunuyor.
Şirketin aktardığı kamuya açık kilometre taşları birkaç aya yayılıyor:
- Temmuz 2026: Tiangai 300, Dünya Yapay Zekâ Konferansı’nda tanıtıldı.
- Temmuz 2026: Shanghai Electric Group, H200 iş hacmi karşılaştırmasında alıntılanan üçüncü taraf testini tamamladı.
- Ekim ayındaki medya etkinliğinden önce: IXL144 sistem tasarımı, Çin Uluslararası Sanayi Fuarı’nda sergilendi.
- 28 Ekim 2026: Iluvatar CoreX, Şanghay’da Tiangai 300 donanımının canlı gösterimlerini medyaya açtı.
Ekim etkinliği, ürün anlatımını mimari sunumlarından adı belirtilen iş yüklerini çalıştıran sistemlere taşıdı. Şirketin aktardığı kullanım seçenekleri artık tekil hızlandırıcı kartlardan sekiz kartlı sunuculara ve daha büyük IXL144 sistemine uzanıyor.
144 GPU etrafında tasarlanan bir sistem
Iluvatar CoreX’e göre IXL144, tek bir standart sunucuda 144 GPU ile 18 CPU’yu bir araya getiriyor ve yaklaşık 10,1 TB toplam GPU belleği sunuyor. Şirket, bunu tek bir sunucu kabinine yerleştirilmiş sektörün en yoğun GPU süper düğümü olarak tanımladı. Süper düğüm, çok sayıda işlemciyi büyük işlerde birlikte çalışabilecekleri şekilde birbirine yakından bağlar.
Tiangai 300 için belirtilen kart başına 144 GB ve sistemin toplamı olarak açıklanan 10,1 TB bellek değerlerinin daha net bir yapılandırma dökümüne ihtiyacı var. Kapasitenin hesaplanma biçimindeki farklılıklar hesaba katılmadan, 144 kartın 144 GB ile çarpımı 20.736 GB ediyor. Sistem açıklamasında kart yapılandırmasının ve iş yüklerinin kullanabildiği bellek kapasitesinin belirtilmesi gerekiyor.
Iluvatar CoreX, sistemin uluslararası ana akım sistemlere kıyasla bir milyon etkin belirteç başına maliyeti yaklaşık yüzde 40 azaltabileceğini tahmin ediyor. Etkin belirteçler, yararlı iş olarak sayılan çıktıyı ifade eder. Yapay zekâ hizmeti sunan işletmeler için bu ölçüm, donanım harcamasını üretilen kullanılabilir çıktı miktarıyla ilişkilendiriyor.
Yüzde 40’lık bir azalma, referans sistemde 100 birime mal olan işin 60 birime mal olması demektir. Gerçek tasarruf; ekipman fiyatına, enerji tüketimine, yazılıma, iş yüküne ve GPU’ların ne kadar süreyle verimli kullanıldığına bağlı olacaktır.
Şirket, yeni nesil eşler arası bağlantı motoru için de bir hedef açıkladı: Bağlantılı alan içindeki tek bir aktarımın süresini 3 ila 5 mikrosaniyeden 1 mikrosaniyeye düşürmek. Farklı GPU’lar modelin farklı bölümlerini tuttuğunda ve tekrar tekrar veri paylaşması gerektiğinde daha hızlı iletişim önem kazanır.
Yapay zekâ işlerini farklı çipler arasında paylaştırma
Iluvatar CoreX’in heterojen dağıtım yaklaşımı, çıkarımın farklı bölümlerini farklı işlemci türlerine atıyor. AFD ayrımı düzeninde Tiangai 300, ön doldurma aşamasının tamamını ve çözümleme sırasındaki dikkat hesaplamalarını üstleniyor. Bir iş ortağının XPU’su ise ileri beslemeli uzman ağlarını çalıştırıyor.
XPU, başka türde bir hesaplama hızlandırıcısını tanımlamak için kullanılan genel bir terimdir. Temel yaklaşım, her işlemciye en iyi yaptığı işi vermek ve ortak bir zamanlayıcının tüm işi eşgüdüm içinde yürütmesini sağlamaktır. İleri beslemeli ağlar, dil modelindeki matematiksel işlemlerin bir diğer önemli bölümünü gerçekleştirir.
Şirket, birleştirilmiş zamanlama altında çözümleme çıkarımı gecikmesinin yüzde 60 azaltıldığını bildirdi. Bu, H200 karşısındaki öne çıkan yüzde 5’lik iş hacmi üstünlüğünden farklı bir performans ölçütüne sahip, ayrı bir sistem yapılandırmasıdır.
Şirketin yapay zekâ ve hızlandırılmış hesaplama birimi başkanı Shan Tianyi, gelecekteki yapay zekâ hesaplama sistemlerinin her iş için tek bir işlemci türüne dayanmak yerine farklı çipleri verimli biçimde düzenlemeye bağlı olacağını söyledi. AFD gösterimi, bu stratejiyi GPU’lar ile iş ortağı hızlandırıcılarından oluşan somut bir düzen içinde uygulamaya koyuyor.
Yazılım iddiaları dağıtım süresini kısaltmayı hedefliyor
Iluvatar CoreX, dağıtım ve optimizasyonun bazı aşamalarını otomatikleştirmeyi amaçlayan yapay zekâ destekli bir yazılım yığını da tanıttı. Şirket, ortam kurulumunun bir saatten 10 dakikaya indiğini, manuel işlem sayısının ise onlarcadan bire düştüğünü belirtti.
Şirket, büyük bir modelin optimizasyonuna yönelik bir görevde çalışma süresini yedi günden iki saatin altına indirdiğini ve performansı önceki düzeyin yaklaşık iki katına çıkardığını bildirdi. Bu örnekler, modellerin donanımda verimli çalışmasını sağlamak için gereken mühendislik işlerini kapsıyor.
Şirket ayrıca GPU hesaplama yordamları geliştirmek için kullanılan FlyDSL ile derin entegrasyon sağlandığını öne sürdü. Derleme hızının yüzde 90’dan fazla arttığını belirten şirket, daha önce 10 kişinin bir gün çalışmasını gerektiren bir iş akışının artık bir kişi tarafından saatler içinde tamamlanabildiğini açıkladı.
Bir işlemcinin etkili aritmetik donanımdan fazlasına ihtiyacı olduğu için yazılım desteği önem taşıyor. Modellerin, matematik kütüphanelerinin ve dağıtım araçlarının birlikte çalışması gerekiyor. Yazılım gösterimleri, müşterilerin yeni bir GPU’yu çalışan bir hizmete dönüştürmeden önce ne kadar mühendislik emeği harcaması gerekebileceğini ele alıyor.
TY1200, iddiayı robotlara da taşıyor
Şanghay’daki etkinlikte, fiziksel dünyayı algılayıp orada hareket eden robotlar da dahil olmak üzere yapay zekâlı bilgisayarları ve fiziksel yapay zekâ uygulamalarını hedefleyen ayrı bir işlemci olan Tongyang TY1200 de sergilendi. İşlemcinin belirtilen yoğun hesaplama kapasitesi 300 TOPS, yani saniyede 300 trilyon işlem. Yoğun hesaplama, sıfır değer içeren işlemlerin atlanmasına dayanmadan yapılan işlemleri sayar.
Iluvatar CoreX, Qwen3.8-27B ve Qwen3.6-35B-A3B modellerini içeren testlerde TY1200’ün Nvidia Thor T5000 performansının 1,2 katına ulaştığını öne sürdü. Fiziksel yapay zekâ senaryolarında Cosmos-R2-2B ve Cosmos-R2-8B modelleri için ise Thor T5000 referansının sırasıyla yüzde 158’i ve yüzde 180’i düzeyinde performans bildirdi.
Şirket, TY1200’ün MuJoCo-Warp kullanarak GPU hızlandırmalı fizik simülasyonu çalıştırabildiğini de belirtti. Böylece robot geliştirme sistemi hareketleri simüle edebiliyor, bir kontrol politikası eğitebiliyor ve eylemleri yerel olarak sınayabiliyor. Kontrol politikası, robotun nasıl hareket edeceğine karar verirken kullandığı öğrenilmiş talimatlar bütünüdür.
Bildirilen uygulamalar arasında tıbbi ziyaretlerde insanlara yardımcı olan robotlar, endüstriyel görüntü işleme ve ziyaretçi yönlendirme yer alıyor. Planlanan yeni model TY2000 için açıklanan hesaplama hedefi 600T. Bu ürünler birlikte, şirketin stratejisini büyük yapay zekâ sunucularından kullanıcılara ve makinelere yakın çalışan ekipmanlara taşıyor.
Öne Çıkan Noktalar
- Iluvatar CoreX, Tiangai 300 donanımını 28 Ekim 2026’da Şanghay’da tanıttı.
- Şirket, Shanghai Electric Group’un testini kaynak göstererek kart başına iş hacminin Nvidia H200 performansının 1,05 katına eşdeğer olduğunu belirtti.
- Sekiz GPU’lu Qwen3-32B eğitim gösteriminde, FP8 hassasiyetinde kart başına H100 iş hacminin 1,33 katına ulaşıldığı bildirildi.
- Öne çıkan üçüncü taraf testinin ayrıntılı yöntemi yayımlanmadı.
- IXL144 sisteminde 144 GPU ve 18 CPU bulunuyor. Şirket, bir milyon etkin belirteç başına maliyetin yüzde 40 azalacağını öne sürüyor.
- GPU’lar ve XPU’lar arasında iş paylaşan ayrı bir dağıtım düzeninin çözümleme gecikmesini yüzde 60 azalttığı bildirildi.
- Etkinlikte yazılım otomasyonu ile yerel yapay zekâ ve robotik simülasyonundaki TY1200 uygulamaları da ele alındı.