Sanal evlerde eğitilen robot gerçek odalarda görev başında
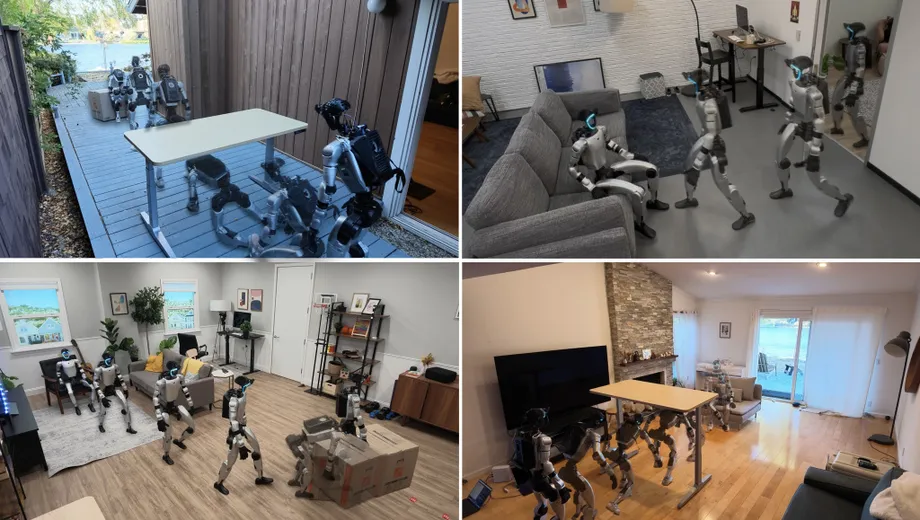
Apple araştırmacıları, HALO adlı insansı robot kontrol sistemlerinin, daha önce taranmamış veya haritası çıkarılmamış altı gerçek ortamda toplam 360 denemede tekil fiziksel görevleri ortalama yüzde 91 başarıyla tamamladığını söylüyor. Unitree Robotics G1 üzerinde çalışan sistem, simülasyonda öğrendiklerinden yararlanarak tanımadığı alanlarda yol buldu, mobilyalara oturdu, dar geçitlerden geçti ve kutuları itti.
İçindekiler
- Sanal evlerde eğitilen robot gerçek odalarda görev başında
- Yüzde 91’lik sonuç neleri kapsıyor?
- Uzun talimatlar neden daha zor?
- Üç katman bir isteği harekete dönüştürüyor
- G1’in üzerinde bir Mac mini taşınıyor
- 1.000 sanal ev eğitim örneklerini nasıl sağlıyor?
- İşlem gücü maliyeti ve insan emeği
- Görme yetisi temas sorununu henüz çözmüyor
- Araştırma neyi değiştiriyor?
- Öne Çıkanlar
Sonuçlar, 4 Kasım 2026’da arXiv’e gönderilen Simülasyondan Algısal İnsansı Hareket başlıklı çalışmada yer alıyor. Apple ekibinin makalesinde, yaklaşık 1.000 bilgisayar tarafından oluşturulmuş ev ortamında 300 saatlik sentetik örnekle eğitim yapıldığı ve ardından sistemin doğrudan fiziksel bir robota aktarıldığı anlatılıyor.
Daha uzun görevler daha zordu. Ayrı bir gerçek ortamda HALO, her biri 10 kez denenen üç eylem dizisinde ortalama yüzde 70 başarı sağladı. Bir engelin altından eğilerek geçmesini, hedefe yaklaşmasını ve kutuyu itmesini gerektiren dizi 10 denemenin beşinde başarıyla tamamlandı.
Uygulamadaki ilerleme, bir isteği anlamakla tanımadığı bir ortamda tüm vücudu hareket ettirmek arasındaki bağlantının kurulması. Sandalyeye oturmak gibi bir komut, robotun oturağı tanımasını, bir güzergâh bulmasını, vücudunu konumlandırmasını ve alçalırken dengesini korumasını gerektiriyor. HALO bu sorumlulukları birlikte çalışan üç kontrol katmanına ayırıyor.
Yazarlar, Apple bağlantısıyla listelenen Siyuan Hu, Abulikemu Abuduweili, Yue Meng, Shipeng Liu, Quentin Leboutet, Chen Chen, Matthias Müller ve Vladlen Koltun. Ekip ayrıca veri üretimi, eğitim ve dağıtımın yanı sıra simülasyonda ve fiziksel robotlarda görev planlama, hareket üretimi ve hareket takibini kapsayan kodları da yayımladı.
Yüzde 91’lik sonuç neleri kapsıyor?
Altı tekil becerinin başarı oranları farklılık gösterdi. En iyi sonuç çömelmede alınırken, test edilen eylemler arasında en düşük başarı oranı oturmada görüldü:
- Adı belirtilen bir nesneye gitme: yüzde 92.
- Mobilyaya oturma: yüzde 85.
- Aralık bırakılarak açık tutulmuş bir kapıdan geçme: yüzde 93.
- Bir engelin altından çömelerek geçme: yüzde 100.
- Bir engelin altından emekleyerek geçme: yüzde 90.
- Bir kutuyu itme: yüzde 88.
Çömelme ile oturma arasındaki fark 15 yüzde puanıydı. Oturmak, doğru noktaya ulaşmaktan fazlasını gerektiriyor: Robotun mobilyaya göre hizalanması ve ağırlığını oturağa aktarması gerekiyor. Bu da hem görsel algısını hem fiziksel kontrol sistemini zorluyor.
HALO, değerlendirme yapılan altı ortamın hiçbirini daha önce görmemişti. Araştırmacılar bu ortamları önceden taramamış ve eğitim sırasında da kullanmamıştı. Makalede bu yaklaşım sıfır örnekli aktarım olarak adlandırılıyor. Yani sistem, her bir hedef ortam için ek eğitim almadan simülasyondaki eğitimden fiziksel ortamlara geçti.
Gösterimlerde G1’in bir kişiyi takip ettiği, kanepeye oturduğu, aralık bırakılarak açık tutulmuş bir kapıdan yana doğru geçtiği ve masanın altından eğilerek ya da emekleyerek ilerlediği de görülüyor. Bu hareketler, sistemin yalnızca bir hedefe doğru yürümek yerine duruşunu çevresindeki alana göre ayarladığını gösteriyor.
Uzun talimatlar neden daha zor?
HALO’nun üç eylem dizisinde sonuçlar daha geniş bir aralıkta değişti. Önce kapıdan geçip ardından hedefe gitme 10 denemenin tamamında başarılı oldu. Önce çömelip sonra oturma altı denemede başarılıydı. Çömelme, hedefe yaklaşma ve kutuyu itme dizisi ise beş denemede başarıya ulaştı.
Bu sonuçlar toplamda 30 denemenin 21’inde başarılı olunduğu, yani yüzde 70 başarı sağlandığı anlamına geliyor. Dizi testleri farklı bir ortamda ve daha az sayıda denemeyle yapıldığı hâlde bu oran, tekil görevlerin ortalamasından 21 yüzde puanı daha düşük.
Bir hareketin sonucu, sıradaki hareketin başlangıç konumunu belirlediği için eylem dizilerinde sorun çıkma olasılığı artıyor. Örneğin bir engelin altından çıkan robotun, hedefe yaklaşabilecek ve sonraki hareketi yapabilecek durumda olması gerekiyor.
HALO bu sorunu görsel kontrollerle ele alıyor. Planlayıcı, robotun bakış açısından alınan videoyu izliyor, mevcut eylemin başarıyla tamamlanıp tamamlanmadığını değerlendiriyor ve devam etmeye ya da yeniden denemeye karar veriyor. Sonuçlar, işe yarayan becerileri birbirine bağlamanın bu becerileri ayrı ayrı uygulamaktan daha zor olduğunu gösteriyor.
Üç katman bir isteği harekete dönüştürüyor
En üst kontrol katmanı görev planlamasını yürütüyor. Görüntüleri ve sözcükleri birlikte işleyen bir yapay zekâ türü olan görsel-dil modelini kullanarak isteği, kameranın gördükleriyle birlikte yorumluyor. Varsayılan model, robotun taşıdığı Mac mini’de yerel olarak çalışan Qwen3.6-35B-A3B.
Planlayıcı her iki saniyede bir devreye giriyor. Birinden oturması istenen robot, oturacağı yer belirtilmemişse görüş alanındaki uygun nesneyi seçmek zorunda. Sandalyeye giden yolu bir masa kapatıyorsa isteği daha küçük eylemlere ayırabiliyor: engelin altından eğilerek geçmek, sandalyeye yaklaşmak ve oturmak.
Orta katman, her alt görevi bir hareket planına dönüştürüyor. Eğitim sırasında kodlayıcı parametreleri sabit tutulan Qwen3.5-2B’yi, tüm vücut hareketleri üreten bir difüzyon dönüştürücü kod çözücüyle birleştiriyor. Kodlayıcı, görüntüyü ve talimatı hareket modelinin kullanabileceği bir gösterime dönüştürüyor; kod çözücü ise planlanan pozları üretiyor.
Bu katman yaklaşık beş saniye ileriyi değerlendiriyor ve saniyede yaklaşık üç kez yeni plan yapıyor. Böylece çevresini kontrol etmeden beş saniyelik bir eyleme bütünüyle bağlı kalmak yerine, kameradan gelen güncel gözlemlere göre planlanan hareketini sürekli güncelliyor.
Hareket izleyici adı verilen en alt katman, bu planları saniyede 50 kez eklem komutlarına dönüştürüyor. Derinlik görüntülerini robotun kendi konumu ve hareketine ilişkin bilgilerle birleştirerek dengeyi, temas koşullarını ve motor sınırlarını hesaba katarken planı uygulamasına yardımcı oluyor.
G1’in üzerinde bir Mac mini taşınıyor
Fiziksel düzende, M4 Pro çipli ve 64 GB birleşik belleğe sahip bir Mac mini, koruyucu bir muhafaza içinde G1’in sırtına yerleştirilmiş. Bu bilgisayar, daha fazla işlem gücü gerektiren görev planlama ve hareket üretimi modellerini çalıştırıyor. G1’in kendi yerleşik işlemcisi ise hareket izleyiciyi çalıştırıyor.
Özel bir başlık, OAK-1W kamerayı taşıyor. Kameranın renkli video akışı 1280 x 800 piksel çözünürlüğe, saniyede 30 kare hızına ve 120 derecelik görüş alanına sahip. Geniş görüş açısı, robot hareket ederken yakındaki mobilyaları ve geçitleri gözlemlemesine yardımcı oluyor.
Robot bağlantı kablosu olmadan çalışıyor; yazılım bileşenleri mesajlaşma sistemi ZeroMQ üzerinden iletişim kuruyor. Varsayılan yerel yapılandırması internet bağlantısı olmadan çalışabiliyor. İlgili ayarlar yapıldığında HALO, bir uygulama programlama arayüzü üzerinden bulut modeline de başvurabiliyor.
İşlem gücünün paylaştırılması, kontrol hiyerarşisine uygun. Bir isteği anlamak daha seyrek yapılabilirken, hareket hâlindeki bir robotu dengede tutmak çok daha sık güncelleme gerektiriyor. Hareket izleyici mevcut planı uygulamayı sürdürürken hareket üreteci yeni bir plan hesaplıyor; böylece model her hesaplama yaptığında robotun durması gerekmiyor.
1.000 sanal ev eğitim örneklerini nasıl sağlıyor?
HALO’nun eğitim hattı belirli bir veri açığını kapatmayı hedefliyor: İnsansı robotun gördüklerini, kendisinden yapmasının istendiği şeyi ve tüm vücudunun nasıl hareket etmesi gerektiğini bir araya getiren örnekler. Sıradan videolarda eylemlerin görüntüleri bulunuyor ancak bu sistemi eğitmek için görüntülerin talimatlarla ve ayrıntılı robot hareketleriyle eşleştirilmesi gerekiyor.
Yazarlar, insan kontrolüyle veya giyilebilir kayıt cihazlarıyla gösterimler toplayan bazı yöntemlerin gerektirdiği süreyi şöyle açıklıyor:
Her bölümü bir kişinin elle canlandırması gerektiğinden, bir saatlik veri en az bir saatlik insan emeğine mal oluyor.
HALO bunun yerine eşleştirilmiş örnekleri simülasyonda oluşturuyor. Süreç, bir görevin hareket bölümlerine ayrılmasıyla başlıyor. Örneğin bir koltuğa oturmak; ileri yürümeyi, dönmeyi ve oturağa alçalmayı içerebiliyor. Kimodo adlı hareket üretim modeline metin komutları, güzergâh ara noktaları ve kilit pozlar rehberlik ediyor.
Ardından otomatik geometrik kontroller; ayakların kayması, vücudun zeminden geçmesi, ani sıçramalar ve eklemlerin sınırlarının ötesinde hareket etmesi gibi sorunlara göre hareket adaylarını puanlıyor. İşlem hattı, en iyi adayı sanal bir odaya yerleştirmeden önce seçiyor.
Prosedürel sahne oluşturucu Infinigen; oturma odaları, ofisler ve yatak odaları dâhil, farklı yerleşim ve mobilyalara sahip 1.000 ortam sağlıyor. Sistem, robotun planlanan hareketinin ve hedef nesnenin çevredeki mobilyalara çarpmadan sığacağı konumları arıyor.
Ardından bir simülatör, fiziksel kurulumla eşleştirilmiş sanal balıkgözü kamerayı kullanarak robot eylemi gerçekleştirirken göreceği görüntüleri oluşturuyor. Aydınlatma, pozlama, renk, kontrast, bulanıklık ve sensör gürültüsündeki değişiklikler görüntü çeşitliliğini artırıyor. Sonuçta ortaya çıkan her örnek bir talimatı, kamera görüntüsünü ve buna karşılık gelen vücut hareketini bir araya getiriyor.
İşlem gücü maliyeti ve insan emeği
Ana eğitim veri kümesinin oluşturulması, 250 Nvidia H100 grafik işlemcisiyle yaklaşık 48 saat sürdü. Yaygın olarak GPU adıyla bilinen bu işlemciler çok sayıda hesabı paralel biçimde yürütüyor ve büyük miktarda simülasyon verisinin aynı anda üretilmesini sağlıyor.
Eylem üreteci, 64 Nvidia B200 GPU kullanılarak taklit öğrenmesiyle eğitildi. Taklit öğrenmesinde model, örnek davranışları yeniden üretmeyi öğreniyor. Hareket izleyici ise pekiştirmeli öğrenmeyi politika damıtmayla birleştiren eğitimde dört H100 GPU kullandı.
Pekiştirmeli öğrenme, bir kontrol sistemini denemeler ve ne kadar iyi performans gösterdiğine ilişkin geri bildirimlerle eğitiyor. Politika damıtma, öğrenilmiş davranışı başka bir modele aktarıyor. HALO’da bu yöntemler, izleyicinin planlanan pozları fiziksel robotun uygulayabileceği hareketlere dönüştürmesine yardımcı oluyor.
Sürecin bazı bölümlerini insanlar hâlâ belirliyor. Yeni bir fiziksel görev eklemek için komutların yazılması ve kilit pozların tasarlanması gerekiyor; bazı hareketlerde insan videolarından veya hareket yakalama kayıtlarından yararlanılıyor. Görev tanımları ve kısıtlamalar oluşturulduktan sonra işlem hattı bunları çok sayıda üretilmiş odada yeniden kullanabiliyor.
Dolayısıyla değişen şey, gösterimlerin nasıl çoğaltıldığı. Her bölümü bir kişinin gerçekleştirmesi yerine HALO, bir görevin çok sayıda çeşidini üretmek ve kontrol etmek için işlem gücü kullanıyor.
Görme yetisi temas sorununu henüz çözmüyor
Araştırmacılara göre HALO şu anda ağırlıklı olarak görmeye dayanıyor ve teması doğrudan algılayamıyor. Bir nesnenin kameranın görüş alanından çıktığı veya başka bir nesnenin arkasında kaldığı durumlarda, yoğun fiziksel temas içeren görevlerde performans düşebiliyor.
Kutu itmek, bunun neden önemli olduğunu gösteriyor. Robotun, kutu hareket ederken vücudunu kutuya göre doğru konumda tutması gerekiyor. Kamera görünür konum bilgisi sağlayabilirken dokunma algısı, görüş engellendiğinde de işe yarayan temas bilgisi sunabilir.
Araştırmacılar, ileride yapılabilecek çalışmalardan biri olarak dokunsal algılamayı gösteriyor. Bu özelliğin ne zaman ekleneceğine ilişkin bir takvim vermiyorlar. Mevcut sonuçlar sorunun sınırlarını somut biçimde ortaya koyuyor: HALO tanımadığı odalarda görsel yönlendirmeyle çeşitli becerileri gerçekleştirebiliyor, ancak uzun eylem dizileri ve temas içeren etkileşimler daha az güvenilir kalıyor.
Araştırma neyi değiştiriyor?
Apple’ın çalışması; eğitim verisi üretimini, dil tabanlı planlamayı ve fiziksel kontrolü, daha önce karşılaşmadığı odalarda çalışan tek bir insansı robot sisteminde bir araya getiriyor. En güçlü sonuç, altı test konumunun önceden haritası çıkarılmadan 1.000 simülasyon ortamından 360 fiziksel denemeye aktarım yapılması.
Yayımlanan kodlar, simülasyon ve donanım üzerinde daha ileri araştırmalar için bu işlem hattını kullanıma açıyor. Kapsamda hem eğitim örnekleri üretmeye yarayan araçlar hem de hareketleri üretmek, izlemek ve koordine etmek için gereken modeller ve yazılımlar bulunuyor.
Bir kişi robottan oturmasını veya bir kutuyu hareket ettirmesini istediğinde güvenilirlik, tüm adımların birlikte çalışmasına bağlı: Doğru nesneyi tanımak, ona ulaşmak, temas kurmak ve hareketi tamamlamak. HALO’nun tekil görev sonuçları bu zincirde ilerleme kaydedildiğini gösteriyor. Eylem dizilerindeki sonuçlar ise birden fazla eylemi aynı tutarlılıkla birleştirebilmek için nerede daha fazla çalışılması gerektiğini ortaya koyuyor.
Öne Çıkanlar
- Apple araştırmacıları, Simülasyondan Algısal İnsansı Hareket başlıklı çalışmayı 4 Kasım 2026’da arXiv’e gönderdi.
- HALO, tanımadığı ve haritası çıkarılmamış altı gerçek ortamda 360 tekil görev denemesinde ortalama yüzde 91 başarı elde etti.
- Üç görev dizisi, başka bir gerçek ortamda yapılan 30 denemede ortalama yüzde 70 başarı sağladı.
- Sistem; görev planlamayı, hareket üretimini ve saniyede 50 kez eklem komutu veren bir izleyiciyi bir araya getiriyor.
- Eğitimde, üretilmiş 1.000 ortamda yaklaşık 300 saatlik sentetik örnek kullanıldı.
- Unitree G1’in taşıdığı Mac mini, internet bağlantısı olmadan yerel çalışmayı destekliyor.
- Eğitim sürecinde görevlerin insanlar tarafından tasarlanması gerekiyor; sınırlı temas algısı da sistemin zayıf yönlerinden biri.