RNA harflerini ve aralarındaki bağlantıları öğrenen bir model
Çin Bilim ve Teknoloji Üniversitesi'ndeki araştırmacılar, 21 milyon RNA dizisi ve hesaplamalı olarak anotlanmış yapı çiftiyle eğitilen açık bir RNA temel modeli olan structRFM'yi yayımladı. Yayın; eşleştirilmiş eğitim verilerini, model ağırlıklarını ve kaynak kodunu içeriyor. Böylece diğer laboratuvarlar çalışmayı tekrarlamak ve sistemi uyarlamak için gerekli materyallere erişebiliyor.
İçindekiler
- RNA harflerini ve aralarındaki bağlantıları öğrenen bir model
- Katlanma neden dizi kadar önemli?
- 21 milyon eğitim çifti nasıl oluşturuldu?
- Modeli gizlenmiş bilgilerle eğitmek
- Yapı testleri ne gösterdi?
- RNA işlenmesinden işlevsel sınıflandırmaya
- Açık yayın araştırmacılara ne sağlıyor?
- Ekip ve yayın takvimi
- Sonuçlar RNA araştırmaları için neyi değiştiriyor?
- Öne Çıkanlar
Nature'ın 4 Kasım 2026'da yayımladığı çalışma, RNA'nın moleküler yapı taşlarının sırasını ve bu moleküllerin katlanmasına yardımcı olan bağlantıları birlikte öğrenen bir modeli anlatıyor. Üç boyutlu yapı tahmini için uyarlanan ve Zfold adı verilen model, yazarların değerlendirmesine göre CASP15-natural, CASP16 ve RNA-Puzzles testlerinde AlphaFold3 ile karşılaştırılabilir bir performans gösterdi.
structRFM'nin pratik açıdan öne çıkan yanı, eğitimden sonra girdi olarak yalnızca bir RNA dizisine ihtiyaç duyması. Model, araştırmacıların moleküler yapı tahmini, RNA işlenmesinde rol oynayan bölgelerin belirlenmesi ve RNA moleküllerinin işlevlerine göre sınıflandırılması gibi çeşitli görevlerde kullanabileceği bilgiler üretiyor.
Nature'da yayımlanan structRFM araştırma makalesi, çalışmayı yapısal bilgiyi farklı tahmin görevlerinde kullanılabilir kılmanın bir yolu olarak sunuyor. Peng Xiong ve S. Kevin Zhou sorumlu yazarlar, Heqin Zhu ise ilk yazar.
Katlanma neden dizi kadar önemli?
RNA; protein üretiminde, gen düzenlenmesinde ve genetik mesajların işlenmesinde rol oynar. RNA dizisi, yaygın olarak A, U, C ve G harfleriyle gösterilen nükleotit adlı moleküler birimlerin sıralanışıdır. Bu sıra bilgi taşırken molekülün katlanma biçimi de nasıl işlev göreceğini belirlemeye yardımcı olur.
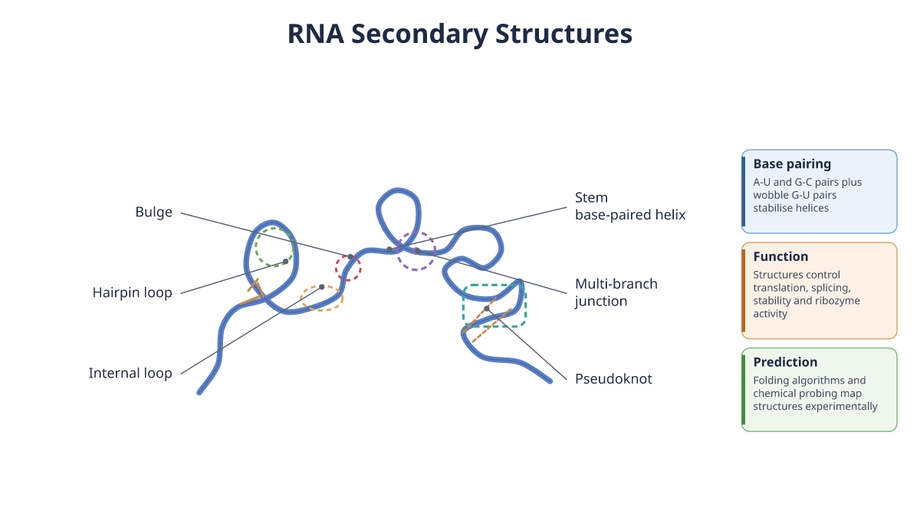
Bir RNA zincirinin bazı bölümleri, aynı zincirin başka bölümleriyle eşleşebilir. Bu bağlantılar; eşleşmiş bölgeler, gövdeler ve ilmeklerden oluşan bir örüntü olan ikincil yapıyı meydana getirir. Molekül daha sonra, etkinliğini ve diğer moleküllerle etkileşimlerini etkileyen, üçüncül yapı adı verilen üç boyutlu bir şekle katlanır.
Pek çok RNA dil modeli, bir dil modelinin sözcükler arasındaki ilişkileri öğrenmesine benzer biçimde, geniş dizi koleksiyonlarından örüntüler öğrenir. structRFM, eğitim sırasında hangi nükleotitlerin eşleştiğine ilişkin bilgileri de kullanarak dizide birbirinden uzak konumlar arasındaki bağlantıları öğrenmesine yardımcı olur.
Araştırmacılar, geniş kapsamlı biçimde eğitilmiş ve öğrendiği özellikleri farklı amaçlara uyarlanabilen bir sistem olan temel modelin esnekliğini korumayı hedefledi. Amaçları, katlanma bilgisini yalnızca tek bir yapısal görev için yararlı bir sistem eğitmek yerine ortak temele dahil etmekti.
21 milyon eğitim çifti nasıl oluşturuldu?
Ekip, yaklaşık 21 milyon RNA dizisi ve ikincil yapı çiftinden oluşan bir veri kümesi hazırladı. Yapısal anotasyonlar hesaplamalı yöntemlerle üretildi. Bu sayede araştırmacılar, yalnızca laboratuvar deneyleriyle çözümlenen yapılardan oluşan bir koleksiyonun sağlayabileceğinden çok daha büyük ölçekte eğitim yapabildi.
Bilgisayar tahminleri hatalar içerebilir ve bu tahminleri üreten yöntemin güçlü ve zayıf yönlerini yansıtabilir. Araştırmacılar tek bir tahmin aracına bağımlılığı azaltmak için MUSES adlı, birden çok kaynağı bir araya getiren bir ikincil yapı topluluk yöntemi geliştirdi. Topluluk yöntemi, tamamen tek bir kaynağa bağlı kalmak yerine çeşitli tahmin kaynaklarından gelen bilgileri birleştirir.
MUSES, tahmin edilen yapılardan model eğitirken karşılaşılan temel bir sorunu ele alıyor: Eğitim anotasyonlarında tekrar eden hatalar, modelin öğrendiklerini şekillendirebilir. Yapısal tahminleri birleştirmek, baz eşleşmelerine ilişkin yararlı bilgileri korurken tahmin aracı yanlılığını azaltmak üzere tasarlandı.
Çalışmanın eğitim ve değerlendirme kaynakları arasında RNAcentral, Rfam ve Protein Data Bank gibi yerleşik biyolojik koleksiyonlar bulunuyor. Veri açıklamasında, deneylerde kullanılan veri kümelerinin izlenebilmesi için RNAcentral 24.0 ile Rfam 14.10 ve 15.0 sürümleri dahil ilgili sürümler belirtiliyor.
Modeli gizlenmiş bilgilerle eğitmek
structRFM, girdinin bazı bölümlerinin gizlendiği ve modelin çevresindeki bağlamdan eksik bilgileri çıkarmayı öğrendiği bir eğitim yöntemi olan maskeli dil modellemesini kullanıyor. RNA söz konusu olduğunda bu, sözcükler arasındaki ilişkileri değil, nükleotitler arasındaki ilişkileri öğrenmek anlamına geliyor.
Ekip, baz eşleşmelerini eşleştirme işlemiyle bu sürece dahil etti. Dinamik maskeleme oranı, yapısal bağlantıların yön verdiği eğitim ile tek tek nükleotit konumlarının maskelenmesi arasında denge kuruyor. Böylece model hem yerel dizi örüntülerini hem de katlanmayla bağlantılı ilişkileri öğrenme fırsatı buluyor.
Ortaya çıkan model üç tür özellik sağlıyor: dizinin tümüne ilişkin bilgiler, her bir nükleotide ilişkin bilgiler ve nükleotit çiftlerine ilişkin bilgiler. Özellik, başka bir tahmin sisteminin kullanabileceği sayısal bir gösterimdir. Farklı görevler, bu gösterimin farklı düzeylerinden yararlanabilir.
Araştırmacılar ayrıca, katkılarını sınamak için modelin bazı bölümlerini çıkaran veya değiştiren ablasyon deneyleri yaptı. Bu deneyler, bildirilen iyileşmelerde hem yapısal bilginin hem de maskeleme stratejisinin katkısını destekleyerek structRFM'nin tasarım tercihlerine ilişkin kanıt sağladı.
Yapı testleri ne gösterdi?
structRFM, sıfır atışlı homoloji sınıflandırmasında güçlü performans gösterdi. Homoloji, ortak bir evrimsel kökenden miras alınan ilişkileri ifade eder. Bu bağlamda sıfır atışlı sınıflandırma, hedef sınıflandırma görevine özel eğitim yapılmadan, öğrenilmiş gösterimlerin bu ilişkileri tanımada ne kadar yararlı olduğunu sınar.
Yazarlar ayrıca ikincil yapı tahmininde iyileşme ve yeni yayımlanan RNA ailelerinde güçlü performans bildiriyor. RNA ailesi, dizi veya yapı özellikleri ortak olan ilişkili molekülleri bir araya getirir. Yeni yayımlanan ailelerde yapılan testler, modelin yerleşik veri kümelerinde temsil edilen tanıdık grupların ötesinde ne kadar iyi çalıştığını inceler.
Üçüncül yapı tahmini için ekip, üç boyutlu şekilleri tahmin eden bir modelde kullanılmak üzere structRFM'nin öğrendiği özellikleri uyarlayarak Zfold'u geliştirdi. Yazarlar, hem tahmin edilen şekillerde hem de bu tahminlerden çıkarılan ikincil yapılarda iyileşmeler olduğunu bildiriyor.
Zfold, moleküler yapı tahminini değerlendirmek için kullanılan CASP15-natural, CASP16 ve RNA-Puzzles karşılaştırma veri kümelerinde test edildi. Makale, bu değerlendirmelerin tamamında performansını AlphaFold3 ile karşılaştırılabilir olarak nitelendiriyor. Bu karşılaştırma, Zfold'un adı geçen testlerdeki sonuçlarıyla ilgili; temel RNA gösterimlerini ise structRFM sağlıyor.
Çalışma, her kullanım alanını kapsayan tek bir doğruluk puanı yerine çeşitli başarı türleri sunuyor. İlişkili dizileri tanıma, baz çiftlerini tahmin etme ve üç boyutlu bir şekli yeniden oluşturma farklı problemlerdir ve her biri kendine özgü bir değerlendirme gerektirir.
RNA işlenmesinden işlevsel sınıflandırmaya
structRFM, RNA'nın ne yaptığıyla ilgili görevlerde de test edildi. Bunlar arasında kesim-birleştirme bölgelerinin tahmini, iç ribozom giriş bölgelerinin belirlenmesi ve kodlamayan RNA sınıflandırması yer alıyor; böylece değerlendirme moleküler şeklin ötesine taşınıyor.
Kesim-birleştirme bölgeleri, hücrelerin RNA mesajlarını işlerken kullandığı sınırları belirler. Kesim-birleştirme sırasında seçilmiş bölümler çıkarılır ve kalan parçalar birleştirilir. Bu sınırları tahmin etmek, araştırmacıların bir genetik mesajın protein üretiminde kullanılmadan önce nasıl bir araya getirildiğini incelemesine yardımcı olur.
İç ribozom giriş bölgeleri veya IRES öğeleri, protein üretiminden sorumlu hücresel mekanizmanın translasyona içeriden başlamasını sağlayan RNA bölgeleridir. Bunları belirlemek, bir dizi içindeki işlevsel örüntüleri tanımayı gerektirir ve bu nedenle ön eğitim sırasında edinilen bilginin sınandığı başka bir görevdir.
Kodlamayan RNA'lar, protein üretiminde kalıp görevi görmek dışında roller üstlenir. Bunları sınıflandırmak, molekülleri ilgili gruplara atamak demektir. Yazarlar bu işlevsel görevlerde performansın arttığını bildiriyor. Bu da tahmin hedefi yapıdan biyolojik role değiştiğinde öğrenilmiş gösterimlerin yararlı kalmaya devam ettiğini gösteriyor.
Ekip, bölümleme stratejisi kullanarak modeli uzun kodlamayan RNA'ların sınıflandırılmasına da uyarladı. Uzun bir diziyi bölümlere ayırmak, modelin tek parça olarak işlenmesi zor olan girdilerde kullanılmasını mümkün kılıyor.
Açık yayın araştırmacılara ne sağlıyor?
Yayın, farklı amaçlara hizmet eden üç kaynağı kapsıyor. Veri kümesi, öğrenme sırasında kullanılan örnekleri sağlıyor. Model ağırlıkları, eğitim sırasında öğrenilen sayısal değerleri içeriyor. Kaynak kodu ise yazılımın nasıl uygulandığını ve çalıştırıldığını açıklıyor.
Ağırlıklara erişim, araştırmacıların tüm ön eğitim sürecini tekrarlamak yerine önceden eğitilmiş bir modelle çalışmalarına olanak tanıyor. Veri ve koda erişim ise eğitim sürecinin daha yakından incelenmesini, deneylerin tekrarlanmasını ve alternatif yaklaşımların geliştirilmesini destekliyor.
Makale, projenin GitHub deposunu heqin-zhu/structRFM olarak belirtiyor. Ayrıca ön eğitim veri kümesi için 10.5281/zenodo.18272040 DOI numaralı bir Zenodo arşivi, kaynak kodu ve model kontrol noktaları içinse 10.5281/zenodo.18274292 DOI numaralı bir arşiv listeliyor. DOI, bir araştırma kaynağının zaman içinde izlenebilmesini sağlamak üzere tasarlanmış kalıcı bir tanımlayıcıdır.
Veri açıklamasında, eğitim ve test veri kümelerinin proje deposundan herkesin erişimine açık olduğu belirtiliyor. Çalışmada kullanılan işlenmiş IRES bölünmüş veri kümesi ve şekillerin dayandığı kaynak veriler de sunuluyor. Yazarlar, veri erişimine ilişkin herhangi bir kısıtlama olmadığını belirtiyor.
Bu ayrıntılar karşılaştırmalar açısından önem taşıyor. Araştırmacılar hangi veri kümelerinin ve bölümlerin kullanıldığını inceleyebilir, değerlendirmeleri yeniden çalıştırabilir ve farklı bir eğitim tercihinin sonuçları değiştirip değiştirmediğini sınayabilir. Dolayısıyla yayın, modelin yeniden kullanılmasının yanı sıra bulguların denetlenmesini de destekliyor.
Ekip ve yayın takvimi
Çalışma, USTC'nin Biyomedikal Mühendisliği Okulu ve MIRACLE olarak bilinen Tıbbi Görüntüleme, Robotik, Analitik Hesaplama ve Öğrenme laboratuvarı bünyesinde yürütüldü. Yazarlar, Hefei'deki kurumların ve USTC'nin Suzhou İleri Araştırmalar Enstitüsü'nün katkılarını sıralıyor. Ortak yazar Ruifeng Li ise Hangzhou'daki Zhejiang Üniversitesi Bilgisayar Bilimleri ve Teknolojisi Fakültesi'nde görev yapıyor.
Profesör Zhou ve özel araştırma görevlisi Xiong çalışmayı tasarlayıp yönetti. Zhu çerçeveyi tasarlayıp uyguladı, ön eğitimi ve çeşitli yapı tahmini ile RNA sınıflandırma deneylerini yürüttü ve sonuçları analiz etti. Diğer ekip üyeleri homoloji testleri, veri kümesi karşılaştırmaları, IRES belirleme ve yapısal değerlendirme çalışmalarında görev aldı.
Çalışmanın yayımlanması ve kamuoyuna duyurulması iki ayrı takvim gününe denk geliyor:
- 4 Kasım 2026: Nature, Genellenebilir tahmin için yapının yön verdiği açık bir RNA temel modeli başlıklı çalışmanın yayımlandığını duyurdu.
- 5 Kasım 2026: Çalışma ve açık yayın Çin'de kamuoyuna tanıtıldı; çevrimiçi yayının sabahın erken saatlerinde yayımlandığı belirtildi.
Yazarlar, Çin Ulusal Doğa Bilimleri Vakfı, Ulusal Temel Araştırma ve Geliştirme Programı, Jiangsu ve Suzhou'daki araştırma programları ile Shenzhen'deki Sanming Tıp Projesi'nden destek aldıklarını bildiriyor. Çıkar çatışması beyan etmiyorlar.
Sonuçlar RNA araştırmaları için neyi değiştiriyor?
structRFM, çeşitli araştırma faaliyetlerini ortak bir başlangıç noktasında buluşturuyor. RNA işlenmesini araştıran bir laboratuvar, başka bir ekibin katlanmayı incelemek veya kodlamayan molekülleri sınıflandırmak için kullandığı aynı temel modeli uyarlayabilir. Ancak her uygulama, kendine özgü görev geliştirme ve değerlendirme çalışmaları gerektiriyor.
21 milyon eğitim çifti, yapının yön verdiği öğrenme ve yayımlanan kontrol noktalarının birleşimi, araştırmacılara yalnızca bir algoritma açıklaması değil, inceleyebilecekleri somut bir sistem sunuyor. MUSES ve maskeleme deneyleri de diğer ekiplerin sınayabileceği veya değiştirebileceği belirli tasarım tercihleri ortaya koyuyor.
Bildirilen bulgılar, hesaplamalı tahmin ve sınıflandırmaya odaklanıyor. Biyomedikal uygulamalara yönelik çalışmalar, tahmin edilen yapıların doğrulanması ve belirli RNA moleküllerine atfedilen işlevlerin sınanması dahil ek biyolojik deneyler gerektirir.
Makale, klinik bir uygulama için takvim vermiyor. Şimdilik sağlanan en önemli değişiklik erişim: Dünyanın dört bir yanındaki araştırmacılar eğitim kaynaklarına ulaşabilir, uygulamayı inceleyebilir ve bildirilen kazanımların kendi RNA veri kümelerinde de geçerli olup olmadığını araştırabilir.
Öne Çıkanlar
- USTC araştırmacıları, yaklaşık 21 milyon dizi ve ikincil yapı çiftiyle eğitilen RNA temel modeli structRFM'yi yayımladı.
- Model, dizi örüntülerini ve baz eşleşmesi ilişkilerini öğreniyor; ardından yalnızca dizi girdisinden özellikler üretiyor.
- MUSES, yapısal tahmin kaynaklarını birleştirirken dinamik maskeleme eğitim sırasında yapısal bilgi ile nükleotit bilgisi arasında denge kuruyor.
- Yazarlar, güçlü homoloji sınıflandırması ve ikincil yapı tahmininde iyileşme bildiriyor; değerlendirmeler yeni yayımlanan RNA ailelerini de kapsıyor.
- Üçüncül yapı tahmini için yapılan uyarlama Zfold, adı belirtilen üç karşılaştırma veri kümesinde AlphaFold3 ile karşılaştırılabilir olarak nitelenen bir performans gösterdi.
- Veri kümesi, model ağırlıkları, kaynak kodu ve değerlendirme kaynakları yeniden kullanım ve çalışmanın tekrarlanması için herkesin erişimine açık.