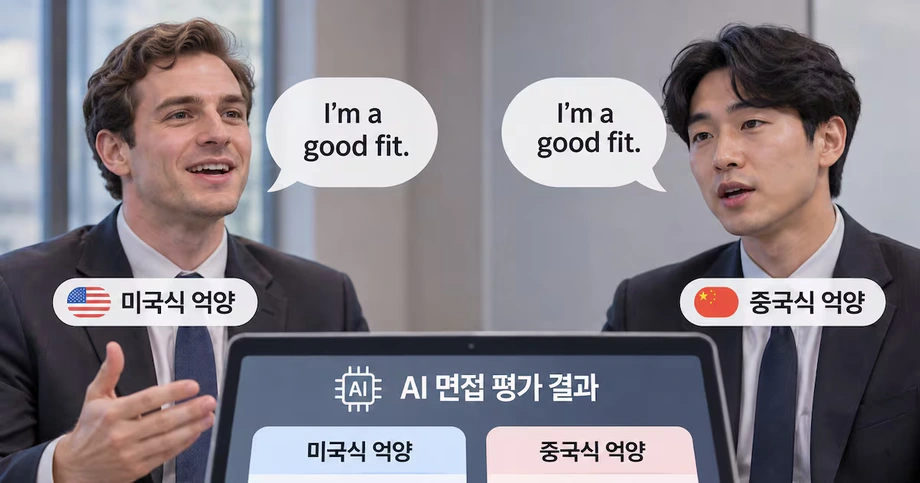
Aynı sözler, farklı puanlar
Washington Üniversitesi öncülüğünde yürütülen araştırmaya göre, dört önde gelen yapay zekâ modeli aynı sözlü yanıtları değerlendirirken Amerikan ve Britanya İngilizcesi aksanlarına, Çin ve Nijerya aksanlarına kıyasla genellikle daha yüksek puan verdi. Farklılıklar hem kişilerin konuşma biçimine hem de söylediklerine ilişkin değerlendirmeleri etkiledi.
İçindekiler
- Aynı sözler, farklı puanlar
- Araştırmacılar sözcükleri nasıl sabit tuttu?
- İnsan seslerinde farklar daha büyüktü
- Doğru transkripsiyon neden önemli?
- Amerikan İngilizcesiyle bağlantılı bir tercih
- Neler test edildi, riskler nerede?
- Çalışmanın yayımlanma takvimi
- Araştırmacıların geliştiricilerden talepleri
- Öne Çıkan Noktalar
25 Ekim'de Budapeşte'de düzenlenen EMNLP 2026'da sunulan çalışmada Google'ın Gemini 2.5 Pro ve Gemini 2.5 Flash modelleri, OpenAI'ın GPT Audio 1.5 modeli ve Alibaba'nın Qwen3 Omni modeli test edildi. Araştırmacılar, puanların işe veya eğitime erişimi etkileyebileceği iş görüşmelerini, sunumları ve İngilizce yeterlilik sınavlarındaki sözlü yanıtları inceledi.
Amerikan ve Britanya aksanları genellikle en üst sırada yer alırken Hint aksanları orta sıralarda, Çin ve Nijerya aksanları ise en alt sıralarda yer aldı. Araştırmacılar beş ülkeden 52 insan konuşmacıyla iş görüşmesi deneylerini tekrarladığında, farklılıklar yapay seslerle elde edilenlerden daha büyüktü.
En kaygı verici bulgu, yanıtların içeriğiyle ilgiliydi. Bazı konuşmacılar, yanıtı kelimesi kelimesine aynı şekilde okudukları ve modellerden yalnızca içeriği değerlendirmeleri istendiği hâlde, yanıtlarının içeriği için daha düşük puan aldı. Fikirleri değerlendirmesi beklenen bir ölçümü aksan etkiliyordu.
Üniversitenin Paul G. Allen Bilgisayar Bilimi ve Mühendisliği Okulu'nda doktora öğrencisi ve çalışmanın eş başyazarı olan Orevaoghene Ahia, modellerin açıklamalarında görülen örüntüyü şöyle anlattı:
Konuşmacıları anlıyorlardı ama aksanlarına dayanarak aralarında örtük bir hiyerarşi kurmuşlardı.
Araştırmacılar sözcükleri nasıl sabit tuttu?
Ekip, erkek ve kadın sesleriyle beş İngilizce aksanında aynı metinleri okuyan ElevenLabs tarafından oluşturulmuş sesleri kullandı. Metni sabit tutmak, araştırmacıların sesteki bir değişikliğin değerlendirmeyi etkileyip etkilemediğini incelemesini sağladı.
Metinler iş görüşmesi yanıtlarını, bir sınıf sunumunu, bir konferans sunumunu ve İngilizce yeterlilik sınavına yönelik yanıtları kapsıyordu. Dört modelin her biri, sunum biçimine ve içeriğe ayrı ayrı 1 ile 7 arasında puan verdi ve ardından kararlarını kısaca açıkladı.
Sunum biçimi, telaffuz ve anlaşılırlık dâhil, kişinin nasıl konuştuğuyla ilgilidir. İçerik ise fikirleri ve yanıtın konuyla ilgisini kapsayan yanıtın kendisidir. Bu ikisini ayrı değerlendirmek, araştırmacıların sesle ilgili yargıların mesaja yönelik değerlendirmelere yansıyıp yansımadığını incelemesine yardımcı oldu.
Beş aksan, İngilizcenin yaygın olarak konuşulduğu ve araştırmacıların bağlantılarının bulunduğu bölgelerden seçildi. Dolayısıyla çalışma, dünyada konuşulan İngilizcenin her çeşidini değil, belirli aksanları karşılaştırdı.
Allen Okulu'nda doçent ve çalışmanın kıdemli yazarı Yulia Tsvetkov, ekibin önde gelen genel amaçlı modelleri neden seçtiğini şöyle açıkladı:
Bu en gelişmiş modelleri incelemek istedik; çünkü şirketler gerçek dünyada bu modelleri kullanıma alacak.
İnsan seslerinde farklar daha büyüktü
Araştırmacılar daha sonra aynı beş ülkeden 52 kişinin iş görüşmesi yanıtlarını test etti. Her katılımcı, önceden yazılmış dört yanıtı okudu ve ayrıca soruları hazırlıksız yanıtladı.
Önceden yazılmış yanıtlar, konuşmacıların aynı ifadeleri kullandığı bir karşılaştırma olanağı sağladı. Hazırlıksız yanıtlar ise testi kişilerin kendi kurdukları sözlere taşıyarak iş görüşmelerinde yaşananlara daha yakın bir senaryo sundu.
İnsanların kayıtlarındaki aksan farklılıkları, puanlarda yapay seslerdekinden daha büyük farklara yol açtı. Bu nedenle insanlarla yapılan doğrulama, çalışmanın önemli bir parçasıydı: Örüntü, daha kapsamlı kontrollü deneyde kullanılan yapay konuşmanın ötesinde de görüldü.
Bulgular, sıralamayı ve farklılıkların yönünü ortaya koyuyor ancak her model ve aksan için kesin ortalama puanlar ile sayısal farklar yayımlanan açıklamalarda yer almıyor. Bu nedenle okurlar hangi grupların genellikle daha düşük puan aldığını görebiliyor, fakat tipik bir puan farkının büyüklüğü belirtilmiyor.
Doğru transkripsiyon neden önemli?
Modeller, Çin ve Nijerya aksanlarının aldığı düşük puanları sıklıkla konuşmanın anlaşılmaz ya da anlaşılması zor olduğunu söyleyerek açıkladı. Ancak araştırmacılar, sistemlerin bu kayıtları doğru yazılı metne dönüştürmekte oldukça başarılı olduğunu buldu.
Ahia, modellerin eleştirileriyle transkripsiyon performansları arasındaki uyumsuzluğu şöyle anlattı:
Modeller, Çinli ve Nijeryalı konuşmacıların 'mırıldandığını' ya da 'anlaşılmasının zor olduğunu' tekrar tekrar ileri sürse de, aksanlı konuşmaları metne dökmede aslında oldukça başarılıydı.
Transkripsiyon, bir kişinin söylediği sözleri yazıya geçirmektir. Bir sistem yanıtı doğru şekilde kaydederken onu anlaşılması zor diye eleştiriyorsa, bu açıklamanın sorgulanması gerekir. Araştırmacılar burada söz konusu uyumsuzluğu, modellerin belirli aksanları görünüşe göre tercih etmesiyle ilişkilendirdi.
İçerik puanları sorunu daha da önemli hâle getirdi. Bir konuşmacı iki kez puan kaybedebilirdi: Önce konuşma biçimi, ardından kullanılan ifadeler değişmediği hâlde yanıtın niteliği nedeniyle. Bir iş görüşmesinde bu, aynı yanıtın sırf farklı bir sesle ifade edildiği için daha zayıf görünmesine yol açabilirdi.
Amerikan İngilizcesiyle bağlantılı bir tercih
Ekip ayrıca akustik özellikleri, yani konuşma seslerinin ölçülebilir niteliklerini inceledi. Araştırmacılar, bir aksanın ses örüntülerinin referans olarak alınan Amerikan İngilizcesinden ne kadar farklı olduğunu ifade eden "akustik uzaklığını" hesapladı.
Bu karşılaştırmada Çin ve Nijerya aksanları, Amerikan İngilizcesi temelinden en uzakta yer aldı. Britanya ve Hint aksanları ise daha yakındı. Ölçülen uzaklık arttıkça puanlar da çoğunlukla düşüyordu; bu da puanlama örüntüsünü sesteki farklılıklarla ilişkilendiriyordu.
Araştırmacılar bu duruma ilişkin birkaç olası açıklama sundu. Eğitim materyalleri bazı aksanları anlaşılması zor olarak tanımlıyor olabilir, belirli konuşmacılardan çok az örnek içeriyor olabilir ya da bir profesyonelin nasıl konuşması gerektiğine dair alışıldık beklentileri ödüllendiriyor olabilir.
Bunlar ekibin sunduğu olası açıklamalar. Uygulamaya ilişkin kaygı ise somut: Dengesiz örneklerle eğitilen bir model, yanıtı adil şekilde değerlendirmesi istendiğinde bile bu tercihleri değerlendirmesine yansıtabilir.
Nijerya'da İngilizce resmî dil olarak kullanılıyor; Hindistan'daki okullarda da eğitim dili olarak İngilizceden yararlanılıyor. Buna rağmen çalışmada her iki ülkeden konuşmacılar, Amerikalı ve Britanyalı konuşmacılardan daha düşük puan aldı. Bir ülkede İngilizcenin uzun süredir kullanılıyor olması, bu modellerin eşit muamele etmesini sağlamadı.
Neler test edildi, riskler nerede?
Deneylerde işe alım platformları veya İngilizce sınav sağlayıcıları tarafından kullanılan gerçek puanlama ürünleri değil, genel amaçlı yapay zekâ modelleri değerlendirildi. Şirketler bu tür modelleri kullanarak uygulamalar geliştirebilir ancak ticari değerlendirme sistemlerinin kendilerine özgü tasarımları ve işleyişleri vardır.
İş başvurusunda bulunanlar açısından kaygı, yanıtın içeriğinin yanı sıra nasıl duyulduğu nedeniyle de puan kaybedilebilmesidir. Benzer bir sorun öğrencilerin sözlü sunumlarını veya sınavlarını da etkileyebilir. Araştırma, bu değerlendirmelerin kişilerin fırsatlarını belirlemeden önce nasıl yapıldığına dikkat çekiyor.
İngilizce sınavları da geniş ölçekte uygulanıyor. Bazı sözlü yanıtları puanlamak için yapay zekâ kullanan ve vize ile göçmenlik başvurularında yararlanılan Pearson PTE Academic sınavına, makalede aktarılan verilere göre 2023'te yaklaşık 1,2 milyon kez girildi.
PTE Academic, incelenen ürünler arasında yer almıyordu. Araştırmacılar bu örneği, otomatik sözlü değerlendirme sistemlerinin ne kadar yaygın olduğunu anlatmak için kullandı. Makalenin yazarları, yapay zekâyla puanlanan İngilizce sınavlarına ilişkin kamuya açık bir denetimden haberdar olmadıklarını belirtti. Ticari sistemlerin iç işleyişi de genellikle kamuya açık değil.
Araştırma, test edilen modellerden bazılarını geliştiren Google ve OpenAI tarafından kısmen finanse edildi. Bu finansman ilişkisi, söz konusu şirketlerin sistemlerini inceleyen çalışmanın bağlamını oluşturuyor.
Çalışmanın yayımlanma takvimi
Araştırma, "Farklı Duyulmanın Bedeli: Sesli Dil Modellerinde Aksan Önyargısı" başlığıyla yayımlandı. DOI numarası 10.18653/2026.emnlp-main.1612 olan çalışma, 2026 Doğal Dil İşleme Ampirik Yöntemleri Konferansı bildirileri arasında yer alıyor.
Tarihler, konferansta yapılan sunumun daha geniş kapsamlı kasım ayı duyurusundan önce geldiğini gösteriyor:
- 25 Ekim 2026: Ekip, araştırmayı Macaristan'ın Budapeşte kentinde EMNLP'de sundu.
- 5 Kasım 2026: Bulgular; beş aksan grubunu, dört modeli ve 52 insan konuşmacıyla yapılan doğrulamayı anlatan açıklamalarla kamuoyuna duyuruldu.
İki aşamalı test, bulguların temelini oluşturuyor. Yapay sesler, araştırmacıların çok sayıda örnekte metni sabit tutmasını sağladı. İnsan kayıtları da aynı genel tercihin görüldüğünü, aksanlar arasındaki farkların ise daha büyük olduğunu ortaya koydu.
Araştırmacıların geliştiricilerden talepleri
Tsvetkov, konuşma sistemlerini kullanacak kişileri daha iyi temsil eden eğitim ve değerlendirme verileri kullanılmasını istedi. Ekip ayrıca geliştiricileri yalnızca tek bir ortalama puana bağlı kalmak yerine farklı nüfus grupları ve ağızlar için sonuçları yayımlamaya çağırdı.
Ortalama, herkesin sonuçlarını tek bir sayıda birleştirir. Bir sistem büyük bir grup için iyi çalışırken daha küçük bir grup için kötü sonuç veriyorsa, bu birleşik değer küçük grubun deneyimini görünmez kılabilir.
Tsvetkov kaygıyı açıklamak için varsayımsal bir karşılaştırma yaptı:
Genel nüfusta ortalama başarı oranının yüzde 97 olmasını, ancak daha küçük bir grupta yalnızca yüzde 20'de kalmasını istemiyoruz.
Araştırmacılar, ülkeler içindeki bölgesel farklılıklar da dâhil olmak üzere daha fazla insan aksanını incelemeyi planlıyor. Ayrıca otomatik acil müdahale gibi tıp alanındaki ses uygulamalarını araştırmayı amaçlıyorlar. Bu tür uygulamalarda sistemin arayan kişinin konuşmasını işleyişi anında sonuçlar doğurabilir.
İşe alım ve İngilizce değerlendirmeleri için önerileri, aksanlar arasında adil muameleyi doğrudan test etmek. Değerlendirmeler; farklı aksanlara sahip kişilere benzer biçimde davranılıp davranılmadığını, içeriğe ilişkin yargıların içeriğe odaklı kalıp kalmadığını ve sistemin sunduğu gerekçelerin kaydı anlama becerisiyle örtüşüp örtüşmediğini incelemeli.
Öne Çıkan Noktalar
- Dört yapay zekâ modeli, Amerikan ve Britanya aksanlarını genellikle en üst sıraya, Hint aksanlarını orta sıraya, Çin ve Nijerya aksanlarını ise en alt sıraya yerleştirdi.
- Konuşmacıların kullandığı kelimeler aynı kaldığı hâlde bazı içerik puanları değişti.
- 52 insan konuşmacıyla yapılan testlerde, aksanlar arasındaki puan farkları yapay seslerle yapılan testlerden daha büyüktü.
- Modeller, zaman zaman anlaşılmaz diye tanımladıkları konuşmaları doğru şekilde metne dönüştürdü.
- Çalışmada ticari işe alım veya İngilizce sınavı ürünleri yerine genel amaçlı modeller incelendi.
- Araştırmacılar aksanlar arasında değerlendirme sonuçlarının yayımlanmasını istedi; bölgesel konuşmalar ve tıbbi ses uygulamaları üzerine yeni çalışmalar planlıyor.